Cómo automatizar procesos de una empresa con agentes de IA
La conversación suele empezar siempre por el mismo sitio: ¿qué proceso automatizamos primero?
Es una pregunta lógica, pero no es la más importante. Con las herramientas que tenemos hoy, casi cualquier proceso administrativo se puede automatizar, al menos en parte. Encontrar candidatos no suele ser el problema.
Lo que realmente determina si el proyecto acaba funcionando en producción o se queda en una demo que hace ilusión durante un par de semanas es otra cosa:
¿Qué pasa cuando el agente se equivoca?
Esa pregunta conviene responderla antes de elegir el proceso, no después de ponerlo en marcha.
Por qué esa es la pregunta importante
Un proceso automatizado no falla exactamente igual que una persona.
Cuando una persona tiene dudas, normalmente pregunta, se para o busca ayuda. Un agente puede tener dudas y aun así tomar una decisión. Y lo más complicado es que puede hacerlo con la misma seguridad aparente con la que toma una decisión correcta.
Por eso, el criterio para elegir un proceso no debería ser únicamente cuánto tiempo vamos a ahorrar.
Hay que preguntarse cuánto cuesta un error que nadie detecta durante semanas.
Un proceso que ahorra veinte horas al mes, pero en el que un fallo silencioso puede hacer que se facture mal a un cliente, puede ser peor candidato que otro que solo ahorra cinco horas y cuyo error se detecta ese mismo día.
La idea de «automatiza primero lo que más tiempo consume» parece razonable, pero muchas veces lleva justo al proceso equivocado.
Los candidatos que sí suelen funcionar
Con ese filtro en mente, los buenos candidatos suelen compartir tres características.
Alto volumen y poca variación
No basta con que una tarea se repita. Lo ideal es que se repita de una forma bastante parecida.
Cien facturas al mes con una estructura prácticamente idéntica son un candidato mejor que trescientas facturas de veinte proveedores diferentes, aunque estas últimas consuman muchas más horas.
El error se detecta pronto
Puede ser porque alguien revisa el resultado como parte del propio proceso o porque existe una comprobación posterior que permite descubrirlo.
Si un error solo aparece cuando se cierra el trimestre, tenemos un problema. La automatización puede haber estado generando resultados incorrectos durante meses sin que nadie lo supiera.
El criterio se puede explicar
Si preguntas cómo se decide algo y la respuesta es «depende, cuando lo ves sabes qué hacer», probablemente no estamos ante un proceso fácilmente delegable.
Ahí hay conocimiento profesional, experiencia y contexto. El agente puede ayudar, preparar información o proponer una decisión, pero no necesariamente debería tomarla por sí solo.
En casi cualquier empresa hay algunos casos que encajan bastante bien en este patrón:
- Clasificar y dirigir el correo entrante.
- Extraer información de documentos con una estructura estable.
- Generar informes recurrentes.
- Pasar información entre sistemas que actualmente no están bien integrados.
No son procesos especialmente llamativos. Y precisamente por eso suelen ser buenos puntos de partida.
El humano en el bucle, pero bien colocado
«Humano en el bucle» se ha convertido en una expresión bastante habitual. El problema es que muchas veces se utiliza como si poner a una persona delante del botón de aprobar resolviera cualquier riesgo.
No funciona así.
Si alguien tiene que revisar y aprobar absolutamente todo lo que hace el agente, en realidad estamos haciendo el trabajo dos veces. Y hay otro problema: después de unas semanas, esa persona probablemente empezará a aprobar cosas sin mirar demasiado.
La supervisión útil tiene que ser selectiva.
El agente debería resolver por su cuenta aquello que está dentro de lo previsto y enviar a revisión lo que se sale de ese margen.
Por ejemplo:
- Importes superiores a un determinado umbral.
- Clientes especialmente sensibles.
- Casos en los que la confianza del modelo sea baja.
- Información que no encaje con los patrones habituales.
- Situaciones que no estén contempladas en las reglas del proceso.
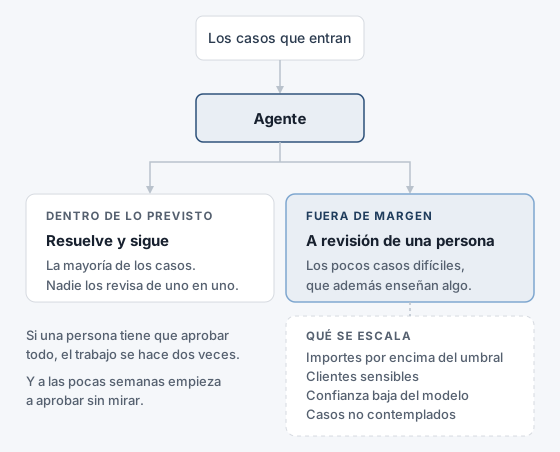
Así, la persona que supervisa no tiene que revisar doscientos casos triviales. Puede centrarse en cinco casos realmente complicados.
Y esos cinco casos tienen además otro valor: permiten descubrir qué partes del proceso todavía no entiende bien el sistema.
Lo que separa una demo de una solución
Una demo normalmente se construye con datos preparados.
Una solución de verdad tiene que funcionar con los datos que existen en la empresa.
Y esos datos suelen estar sucios, incompletos, duplicados o llenos de excepciones que nunca llegaron a documentarse.
Es ahí donde muchos proyectos empiezan a tener problemas.
Y muchas veces el problema ni siquiera está en el modelo de IA.
Está en que el agente no puede acceder correctamente a la información que necesita. Quizá el dato bueno está en otro sistema. Quizá puede consultarlo, pero no tiene los permisos adecuados. O puede acceder a él, pero nadie sabe exactamente qué ha consultado, qué ha modificado o por qué lo ha hecho.
A efectos prácticos, todo eso termina siendo un problema de acceso y gobierno.
La parte menos llamativa del proyecto —qué puede leer el agente, qué puede modificar y qué queda registrado— es precisamente una de las que más importa.
Un agente excelente que no puede acceder a la información necesaria no sirve de mucho.
Uno que sea simplemente correcto, pero que tenga acceso controlado, límites claros y trazabilidad, puede funcionar perfectamente.
Un orden para empezar sin complicarse
Lo primero: elige un solo proceso.
No cinco.
Que sea concreto, medible y que tenga un nivel de riesgo razonable. Si el proceso es demasiado crítico, probablemente nadie te va a dejar experimentar con él. Si no le importa a nadie, tampoco vas a aprender demasiado cuando algo falle.
Después, ponlo a funcionar con datos reales desde el principio, aunque el piloto sea pequeño.
Un piloto construido con datos inventados puede demostrar que el modelo sabe hacer lo que le pedimos. No demuestra que la solución vaya a funcionar en la empresa.
También necesitas saber qué ocurría antes de automatizar.
Mide el proceso actual: cuánto tarda, cuántos casos gestiona, cuántos errores tiene, cuánto cuesta revisarlo. Sin una referencia inicial, dentro de tres meses será difícil demostrar si realmente has mejorado algo.
Y hay una última regla que merece la pena mantener: deja que el sistema pueda equivocarse en algo que tenga solución.
La primera vez que un agente falla suele ser cuando más se aprende sobre el proceso. Aparecen excepciones, reglas que nadie había escrito y dependencias que estaban solo en la cabeza de una persona.
Conviene que ese aprendizaje salga barato.
Cuando un proceso empieza a tener varias fases y cada una necesita criterios diferentes, un único agente puede quedarse corto. Ahí tiene sentido empezar a repartir responsabilidades entre varios agentes.
Es precisamente el escenario que explico en Qué es un equipo de agentes de IA y cuándo compensa.
Tres ideas para quedarse
La primera: no elijas un proceso porque sea el que más horas consume. Elige uno donde el error sea controlable y detectable.
La segunda: el humano en el bucle no consiste en aprobarlo todo. Consiste en intervenir donde realmente hace falta.
Y la tercera: la automatización no termina en el modelo. Los accesos, los permisos, la trazabilidad y la calidad de los datos forman parte de la solución.
Al final, automatizar un proceso con agentes de IA no consiste en conseguir que una máquina haga el trabajo de una persona.
Consiste en decidir qué parte del trabajo puede hacer sola, qué parte necesita supervisión y qué cosas es mejor que sigan estando en manos de alguien.
Cuanto más clara sea esa frontera, más fácil será llevar el proyecto de la demo a producción.
Escrito por José Miguel Azcona Padín · Málaga · más artículos
Las opiniones expresadas en este artículo son personales del autor y no representan la posición de ningún empleador, actual o anterior. El contenido es de elaboración propia y no incluye información confidencial de empresas ni de clientes.